Один говорящий
В исходнике должен быть только нужный голос, без диалогов и чужих реплик.
 Попробовать
Подготовьте образцы своего голоса, чтобы озвучивать новые тексты с узнаваемой подачей. Качество начинается с исходной записи.
Откроется ElevenLabs · внешний сервис
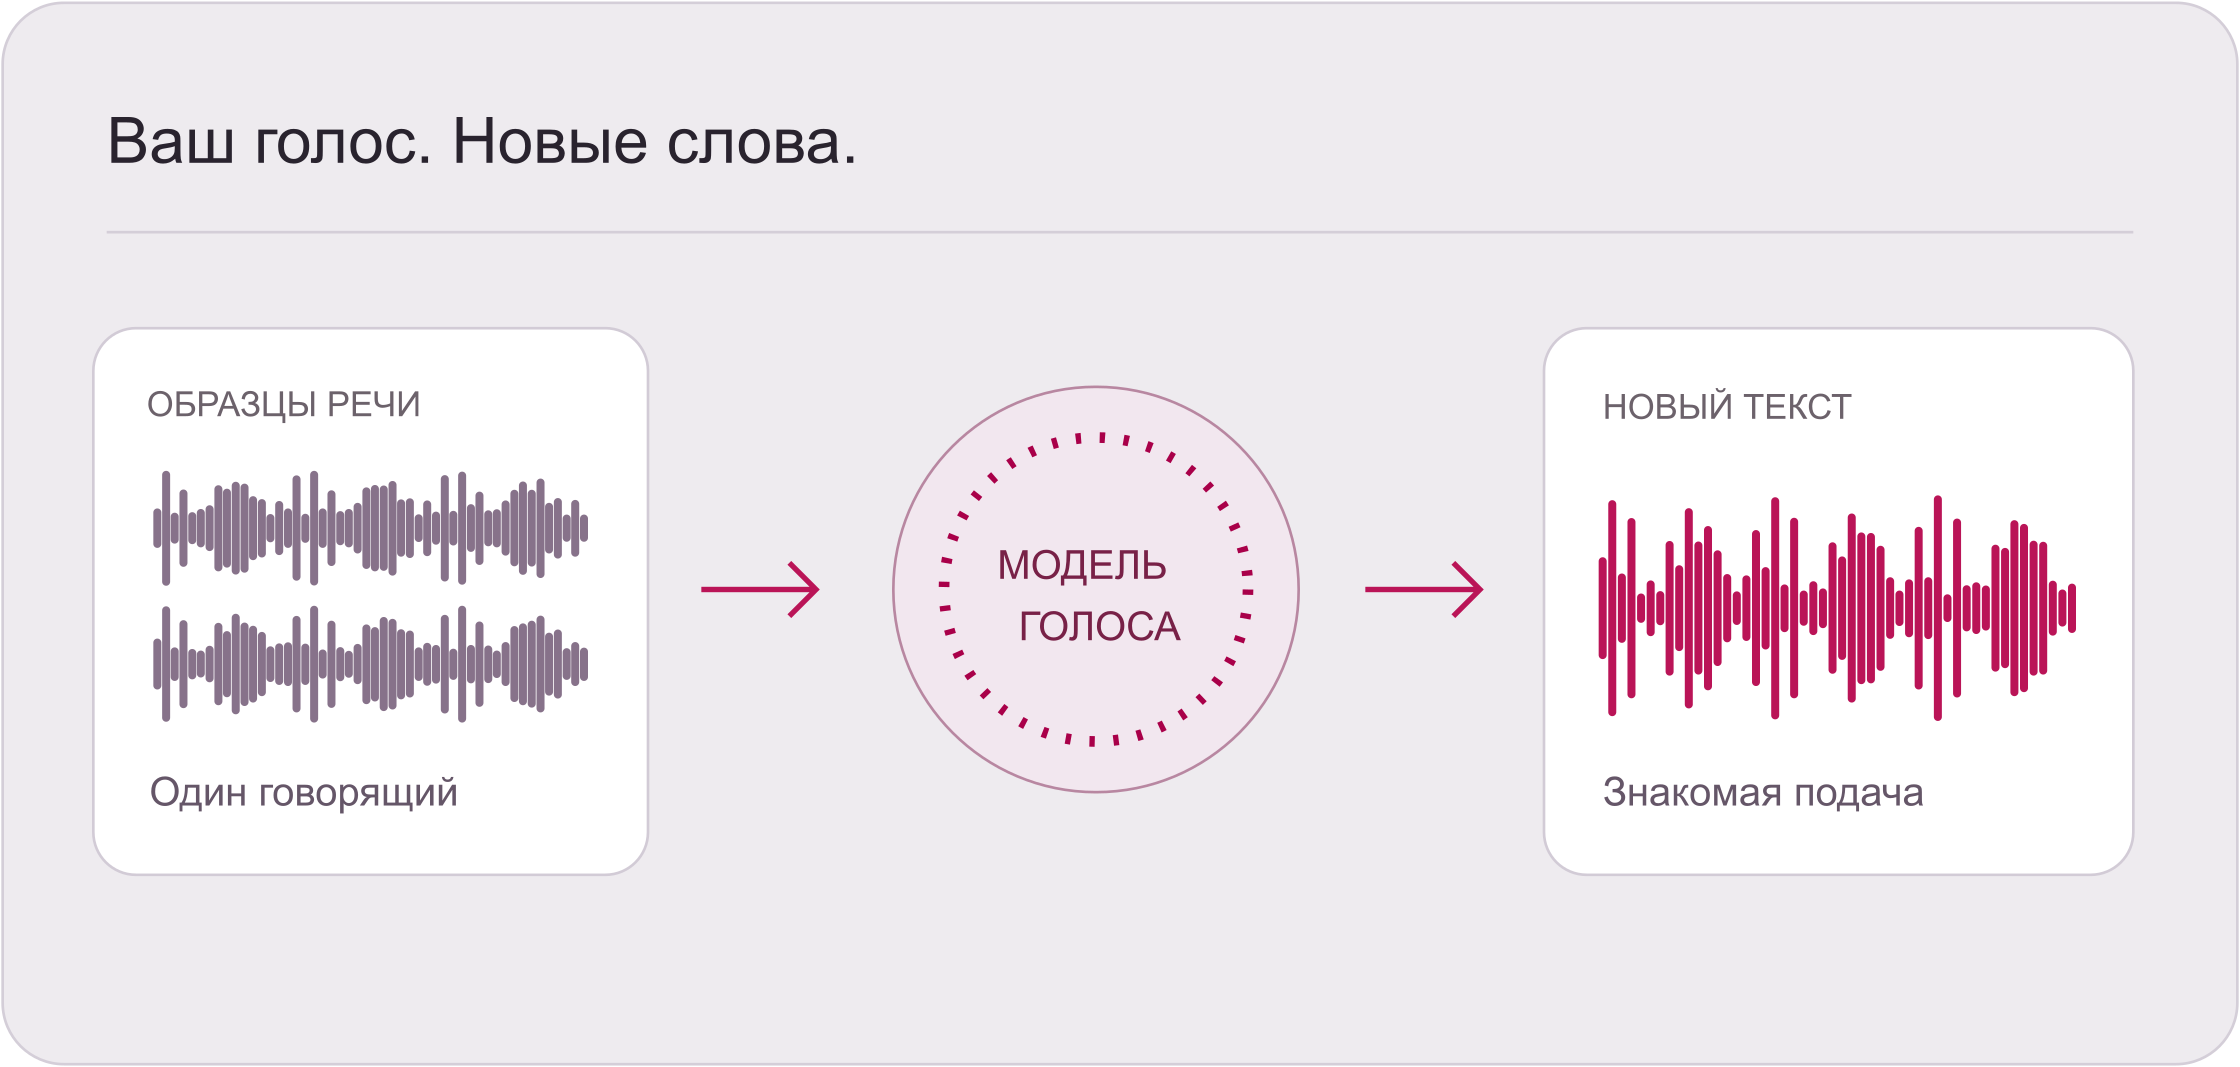
При клонировании система анализирует записи говорящего и создаёт модель, которую можно использовать для синтеза новых фраз. Это отличается от голосового эффекта: вы не просто понижаете уже записанный звук, а получаете инструмент для чтения другого текста.
В ElevenLabs есть разные режимы клонирования с собственными требованиями к образцам и доступу. Выбирайте их под задачу: короткая проверка идеи и длинная последовательная озвучка предъявляют разные требования к материалу.
В исходнике должен быть только нужный голос, без диалогов и чужих реплик.
Фоновая музыка, сильное эхо и перегрузка могут повлиять на качество модели.
Сходные условия записи помогают получить более последовательное звучание.
Работайте со своим голосом. Для чужого требуется явное согласие и соблюдение правил выбранного режима; сервис может ограничивать клонирование только собственным голосом и запрашивать его проверку.
В ElevenLabs сначала выберите режим и прочитайте актуальные требования к длительности и формату. Записывайте естественную речь без музыки и эффектов, с постоянным расстоянием до микрофона.
Возьмите фразы, которых не было в образце: вопрос, спокойное объяснение и эмоциональный акцент. Оцените ударения, тембр и паузы. Сходство на одной реплике не означает одинаковое качество на всех текстах.
Модель может сохранять характерные черты голоса, но иначе произносить имена, менять интонацию или терять естественность на длинных фразах. Планируйте прослушивание и редактуру. Для публичного материала понятно обозначайте синтетическую озвучку, когда её можно принять за настоящую запись человека.
Подробнее: Клонирование в ElevenLabs · О голосах в Udio.
Отбор материала
Перед клонированием голоса прослушайте материал как единый набор. Важен не только технически чистый звук, но и согласованность манеры речи.
Для спокойного рассказа выбирайте образцы естественного объяснения. Резкие переходы от шёпота к крику могут оказаться плохой основой для последовательной подачи.
Уберите длинные паузы, посторонние реплики и места, где говорящий далеко от микрофона. Требования к длине и подготовке уточняйте у выбранного режима сервиса.
Проверка модели
Одной удачной реплики недостаточно для оценки голосовой модели. Возьмите короткие тексты с разными речевыми задачами и используйте один и тот же набор при сравнении версий.
Один набор фраз для каждой сравниваемой версии.
«Сегодня отправляем черновик, а финальную версию — завтра». Проверьте, слышно ли противопоставление.
Добавьте реальные термины своего проекта. Важнее корректность нужных слов, чем сходство на случайной фразе.
«Что изменилось? Голос, паузы или темп?» Послушайте, различаются ли вопросительная интонация и перечисление.
Длинная озвучка
В уроке или большой инструкции слушатель замечает скачки темпа и подачи между частями. Разделите материал на законченные фрагменты и предусмотрите проверку их стыков.
Сначала согласуйте формулировки и произношение важных слов. Частые правки усложняют сравнение звуковых версий.
Воспроизводите конец предыдущего фрагмента вместе с началом нового. Так легче заметить смену интонации или слишком длинную паузу.
Храните принятые реплики отдельно от пробных. После сборки прослушайте весь материал в обычном темпе, не ограничиваясь исправленными местами.
Работа с версиями
Новый набор образцов может изменить характер синтеза. Если текущий голос уже подходит проекту, сохраните контрольные фразы и заметки о нём перед дальнейшими экспериментами.
Послушайте старый и новый результат на одинаковых фразах и сопоставимой громкости. Оценивайте произношение, стабильность и соответствие задаче.
Укажите, что вы пытались исправить: например, неясные окончания или слишком торопливую подачу. Более новое звучание не обязательно полезнее для проекта.
Объём зависит от режима и текущих требований сервиса. Проверьте их до записи: дополнительные минуты не исправят плохой звук, музыку на фоне или несколько говорящих в одном образце.
Не загружайте чужую речь без явного разрешения. Кроме согласия действуют правила платформы: отдельные режимы могут допускать только собственный голос и требовать подтверждения личности говорящего.
Это основной сценарий голосовой модели: по новым словам создаётся синтетическая речь с чертами исходного голоса. Результат нужно прослушать и проверить перед использованием.
Изменение голоса применяет эффект к готовой записи. Клонирование использует образцы для модели, которая может произносить новый текст. Обычный эффект не заменяет голосовую модель.
Согласно справке Udio, функция Voices использует голоса из библиотеки и некоторых ранее созданных песен. Загрузить собственный голос как источник Voices нельзя. Для задачи на этой странице кнопка ведёт в ElevenLabs.
Подготовьте голос для новых историй
ПопробоватьОткроется ElevenLabs · внешний сервис